 AI
AI 一天做出会说话的英语单词卡:SFC 卡带怎么装下 1999 个单词和例句的发音
这次的题目是一款教育游戏:给 12 岁以下、正在学英语的孩子玩的单词卡。打开游戏就能挑战 30 张卡,每张看单词、听发音,再回答“认识”或“不认识”,翻到背面看中文意思和例句。
最后做出来的是一盘 8 MB 的 SFC 卡带,里面有 1999 个单词,每个都有音标、词性、中文意思、例句和翻译,而且单词和例句都会读出来。从开始到可以玩,AI 实际工作的时间约 100 分钟,按 API 价格换算约 29 美元。
怎么玩
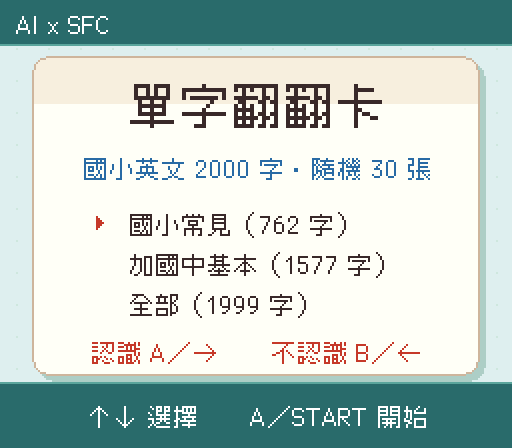
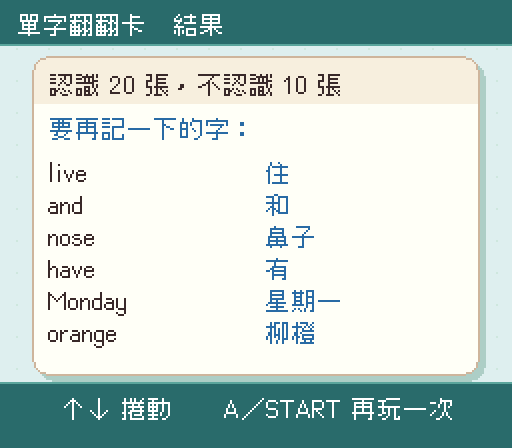
- 正面: 单词和音标,同时读出单词。认识按 A 或 →,还不认识按 B 或 ←,X 再听一次。
- 背面: 词性、中文意思、例句和翻译,同时读出例句。X 读单词、Y 读例句,A 看下一张。
- 结果: 认识几张、不认识几张,以及要再记的词。
设计上刻意不考试:没有选择题、不计时,由孩子自己判断认不认识,再翻面确认。正面只有单词和声音,孩子得先试着想起意思,背面才给答案。每个例句最多 9 个英文单词,只用简单句型。
怎么跟 AI 说的
我们用 Claude Code(Claude Opus 5.5)做这款游戏。下面是用户说的话(略作整理),中间没有写任何代码:
做一款小学生学英语的单词卡游戏:打开就能开始挑战,测试 30 组单词, 只要按 A 或 B(或方向键左、右)回答“认识”“不认识”,就像单词卡那样。 请先准备 2000 个英语单词,是小学毕业时常见需要知道的词汇, 再给一句使用例句。另外单词可以有 KK 音标吗?
AI 先准备好词表,再提出游戏的做法(画面怎么排、字体、操作),用户回了一句“可以”。从提出需求到第一版能玩,大约 35 分钟。试玩之后,用户接着问:
我测试不错哦!那可以加上单词语音,以及读出句子吗?
素材是怎么拿到的
教育游戏的内容要正确,所以每一项我们都先想清楚“从哪里来、能不能用”:
| 素材 | 来源 | 怎么做 |
|---|---|---|
| 2000 词词表 | 公开的英语课程纲要附录(基础 2000 词) | AI 用 macOS 的 PDFKit 从 PDF 提取文字,解析成 1999 条,并保留 37 个主题分类 |
| 音标 | CMU 发音词典(BSD-2-Clause) | 用程序转成 KK 音标,不让 AI 直接写,因为它会记错。一词多音的词按卡片上的意思选读音,例如 read [rid]、live [lɪv]、wind [wɪnd] |
| 中文意思、例句、难度 | AI 生成 | 8 个子代理并行处理,3 分钟完成,再人工修正几条。给孩子正式使用前,建议请老师抽查 |
| 字体 | Cubic 11 像素字体(SIL OFL) | 从字体轮廓 1:1 转成点阵。字体里没有的 17 个音标符号,由 AI 按它的笔画风格自己画 |
| 背景图 | 程序生成 | 卡片、阴影、上下色带都用程序画,只用了 30 个图块 |
| 语音 | Kokoro-82M(Apache-2.0),在本机运行 | 1999 个单词加 1999 句例句,3 个进程并行约 50 分钟。没有用电脑自带的语音,因为它的许可只限个人、非商业使用 |
声音和音标对不上的地方: 文字转语音有自己的读法,有 12 个词和卡片上的音标不一样,例如 live 读成 [laɪv]、close 读成 [klos]、record 读成名词的读法。AI 把两边逐词比对后,这 12 个词改成直接用音标朗读,让孩子听到的和卡片上写的一致。
8 MB 的上限怎么突破
量完所有录音后,问题很清楚:
| 长度 | 放进卡带需要 | |
|---|---|---|
| 1999 个单词 | 约 21 分钟 | 约 6.5 MB(9.5 kHz) |
| 1999 句例句 | 约 47 分钟 | 至少再 25 MB |
SFC 的 CPU 只能寻址 16 MB,其中一半要留给 RAM 和硬件寄存器,所以卡带能直接读到的最多约 8 MB(ExHiROM 格式)。历史上最大的市售卡带也只有 6 MB。单词放得下,例句放不下。
我们比较了三条路:
- 自定义一种换页卡带,超过 8 MB。 卡带上要有一个“换页”电路,程序先选好要读哪一段。这没有统一规格,真机和烧录卡都跑不了,等于自创格式。
- MSU-1。 这是烧录卡支持的扩展规格,外加一个数据文件,游戏再一个字节一个字节读出来。可行,但数据文件要 25 MB,音质也只有 16 kHz。
- HD 素材包(用户提议)。 播放器本来就能用 HD 素材包把游戏的图换成高分辨率图片,那声音为什么不行?
最后选了第三条,做法是这样:
- 卡带里放“提示”: 每句例句在卡带里只放一个 18 字节、几乎无声的小样本,每句都不一样。
- 素材包里放“内容”: 素材包用这个小样本的哈希值当 key,存着那句例句的录音(MP3,24 kHz)。
- 播放器负责对应: 游戏每次让音效芯片播放一个样本,播放器就先计算样本的哈希值。素材包里有这个 key,就改播素材包的录音。录音一样按游戏设定的音高、音量包络和音量播放,长度以录音为准,所以 18 字节的提示可以换成 3 秒的句子。
结果是:ROM 照样是一盘 8 MB、真机能跑的卡带,单词都在里面。加上 23 MB 的素材包,例句就会读出来,单词也换成 24 kHz 的清楚版本。没有素材包时,例句安静,其他都正常。
这个做法不限于语音。游戏发出一个提示,素材包换上丰富的内容,同样的架构可以给每个单词配一张插图或照片(换图块),也可以播放录音版的配乐(游戏在曲子开头播一个专属的提示样本)。HD 声音是播放器的通用功能,任何游戏都能用,见首页的让 AI 提升游戏画质。
成本
| 用户的消息 | 约 10 条:需求、确认做法、加语音、选择做法、反馈问题;没有写任何代码 |
| AI 工作时间 | 约 100 分钟:数据与游戏 34 分钟、语音与修正 66 分钟 |
| 本机运算 | 朗读约 50 分钟(M 系列 Mac 的 CPU,不用显卡、不用云端) |
| 模型 | Claude Opus 5.5,主会话加 8 个子代理,共 269 条回复 |
| AI 输出 token | 44 万 |
| 处理的 token 总数 | 约 7000 万(大部分是缓存读取) |
| 估计费用 | 约 29 美元(以 2026 年 11 月的 Anthropic API 价格换算;订阅方案计费方式不同) |
| 其他费用 | 0:词表、发音词典、字体、语音模型都是公开或开放许可 |
费用里将近一半是“缓存读取”:这次的对话是接在同一天其他工作后面,每次调用都带着很长的上下文。在全新的会话里做,费用会再低一些。
给老师和家长
- 意思、例句和难度是 AI 生成的。我们做了格式和字数检查,也修正了几条,但正式给孩子使用前,请先抽查。
- 卡片上用的是 KK 音标(美式发音)。要改成 IPA,只需要改转换程序和几个字形。
- 游戏界面目前是繁体中文;文字都在排版程序里,改成简体或其他语言只需要换文字。
- 例句语音要在 aixsfc 播放器加上素材包才听得到。真机和其他播放器只会读单词。
想用 AI 做自己的游戏,在空文件夹运行 npx https://aixsfc.app/skill/aixsfc.tgz 再打开 claude,说明在首页。
来源与许可
- 词表:英语课程纲要附录的基础 2000 词(公开文件)。
- 音标:CMU Pronouncing Dictionary,BSD-2-Clause。
- 字体:Cubic 11(俐方体11号),ACh-K,SIL Open Font License 1.1。
- 语音:Kokoro-82M(hexgrad),Apache-2.0。
- 程序、音标字形、背景图:为这款游戏从零制作。本作与任天堂无关,亦未获其背书。